
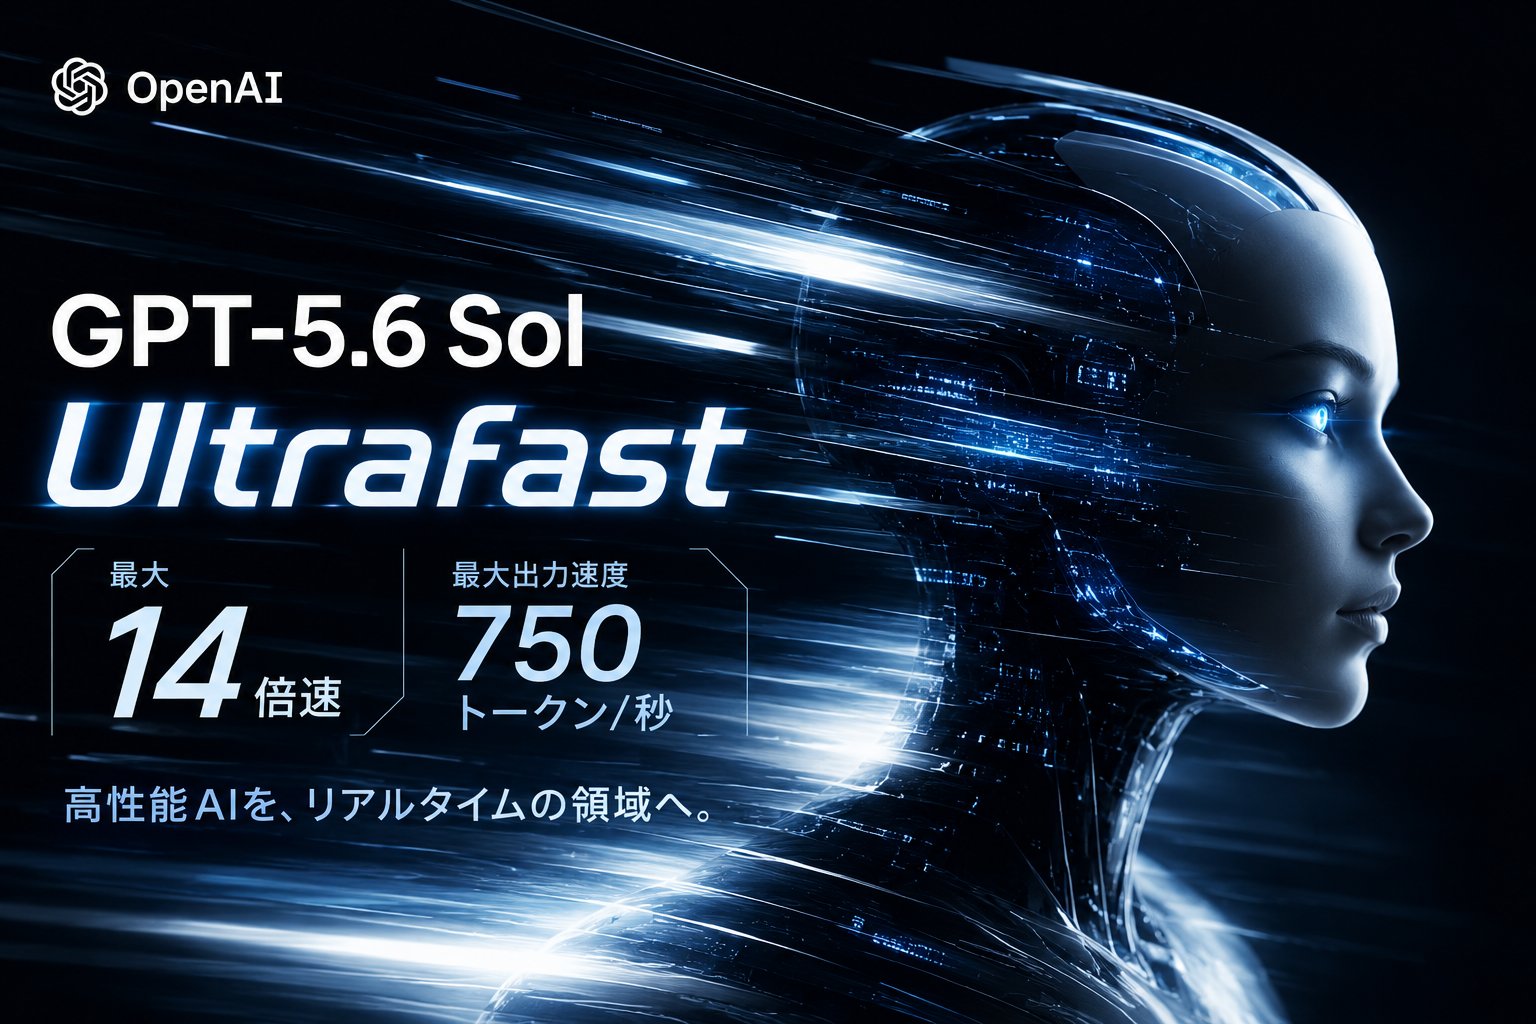
OpenAIは2026年8月13日、最新のフラッグシップAIモデル「GPT-5.6 Sol」を大幅に高速化する新サービスティア「Ultrafast」を発表した。通常のStandard処理と比較して最大14倍の速度を実現し、最大750出力トークン/秒で文章を生成できるという。
単に「ChatGPTの返事が少し速くなる」というレベルではない。OpenAIが狙っているのは、高性能なAIモデルを人間とほぼリアルタイムでやり取りできる領域まで高速化し、AIエージェントの使い方そのものを変えることだ。 (OpenAI)
GPT-5.6 Solとは
GPT-5.6 Solは、OpenAIがGPT-5.6シリーズのフラッグシップとして開発したモデルだ。
GPT-5.6シリーズには、高性能モデル「Sol」、日常業務向けのバランス型「Terra」、高速・低価格型の「Luna」が用意されており、その中でもSolはコーディング、研究、科学、サイバーセキュリティ、コンピューター操作など、複雑なタスクを想定している。
OpenAIは2026年6月の発表時点ですでに、GPT-5.6 SolをCerebrasのハードウェア上で最大750トークン/秒で動作させる計画を明らかにしていた。今回発表されたUltrafastは、その高速推論環境を実際のAPIサービスとして提供するものといえる。 (OpenAI)
最大14倍、750トークン/秒
Ultrafast最大の特徴は、やはりその速度だ。
OpenAIによると、GPT-5.6 SolをUltrafastで利用した場合、Standard処理と比較して最大14倍高速に動作する。生成速度は最大750出力トークン/秒に達する。
従来、大規模で高性能なAIモデルには「賢いが遅い」という問題があった。そのためリアルタイム性が必要なシステムでは、性能をある程度犠牲にして小型モデルを採用するケースも少なくなかった。
Ultrafastが重要なのは、この「性能か速度か」というトレードオフを小さくしようとしている点だ。OpenAIはこれを「more useful work per second(1秒あたりに、より有用な仕事を行う)」という方向性として説明している。 (OpenAI)
高速化を支えるCerebras
この驚異的な速度を支えているのが、AI半導体企業のCerebrasだ。
Cerebrasは、一般的なGPUとは大きく異なる巨大な「Wafer-Scale Engine(WSE)」を開発している。
Cerebrasによると、Ultrafastで利用されるシステムでは、チップ上に44GBのSRAMを搭載。AI推論でボトルネックになりやすいモデルデータの移動を減らし、複数のウェハーにまたがって処理をパイプライン化することで高速なトークン生成を実現しているという。 (Cerebras)
つまり今回のUltrafastは、GPT-5.6 SolというAIモデルだけではなく、AIモデルと専用ハードウェアを組み合わせた高速推論基盤として見る必要がある。
「速いAI」で何が変わるのか
OpenAIが想定している用途の一つがシステム障害への対応だ。
サーバー障害が発生した際、AIがログ、コード変更、エンジニア間の会話、トレース情報などを読み込み、原因を推測して次に確認すべきポイントや修正案を提示する。
こうした作業では「10分後に高品質な回答が返ってくるAI」より、「数秒でかなり高度な分析を返してくれるAI」の方が圧倒的に価値が高い。
ほかにも金融市場の分析、不正取引の検知、リアルタイム顧客サポート、音声AI、ECの商品提案、在庫確認、研究・実験などがUltrafastの利用例として挙げられている。 (OpenAI)
特に注目したいのがAIエージェントだ。
AIエージェントは「考える→ツールを使う→結果を確認する→再び考える」という処理を何度も繰り返す。このため1回あたり数秒の遅延でも、20回、30回と処理すれば大きな待ち時間になる。
モデル自体が大幅に高速化されれば、このエージェントループ全体も高速化できる可能性がある。
実際の仕事では5.6倍高速との結果も
ただし、「最大14倍」という数字には注意が必要だ。
これはStandard処理に対する最大の推論速度であり、すべての仕事が14分の1の時間で終了するという意味ではない。AIエージェントでは検索、外部API、ツール実行など、モデル生成以外にも時間がかかるからだ。
Cerebrasが実施したGDP-Valベンチマークでは、GPT-5.6 Sol UltrafastはStandard版と比較して、エンドツーエンドで5.6倍高速化したとしている。一方で品質の低下は確認されなかったという。 (Cerebras)
この「推論速度14倍、実際のワークフローでも数倍」という違いは、Ultrafastを評価する上で重要だろう。
現在は限定プレビュー
Ultrafastは現時点で誰でも利用できるわけではない。
まずOpenAI APIで提供され、一部の顧客を対象とした限定プレビューとなっている。OpenAIはCerebras側の処理能力を拡大しながら、順次アクセスを広げていく方針だ。 (OpenAI)
今回の発表が示しているのは、生成AI競争の評価軸が「どのモデルが一番賢いか」だけではなくなりつつあることだ。
モデル性能、価格、コンテキスト長に加えて、これからは「高性能なAIをどれだけ速く動かせるか」が重要になる。
750トークン/秒という速度が一般的になれば、AIは「質問して待つツール」から、人間の操作や会話、システムの変化にリアルタイムで追従する存在へと近づいていく。
GPT-5.6 Sol Ultrafastは、単なる高速版モデルというより、「AIの待ち時間」を減らすことで新しいアプリケーションを可能にする試みと見るべきだろう。
関連URL
OpenAI公式:Ultrafast発表
Previewing Ultrafast mode: GPT-5.6 Sol at up to 14X the speed
OpenAI公式:GPT-5.6 Sol
Previewing GPT-5.6 Sol: a next-generation model
OpenAI API:GPT-5.6 Solモデル情報
GPT-5.6 Sol Model | OpenAI API
Cerebras公式:Ultrafastの技術解説
Accelerating GPT-5.6 Sol Ultrafast with OpenAI
TechCrunch
OpenAI introduces ‘Ultrafast,’ a new mode that makes GPT-5.6 Sol work at 14x the speed