
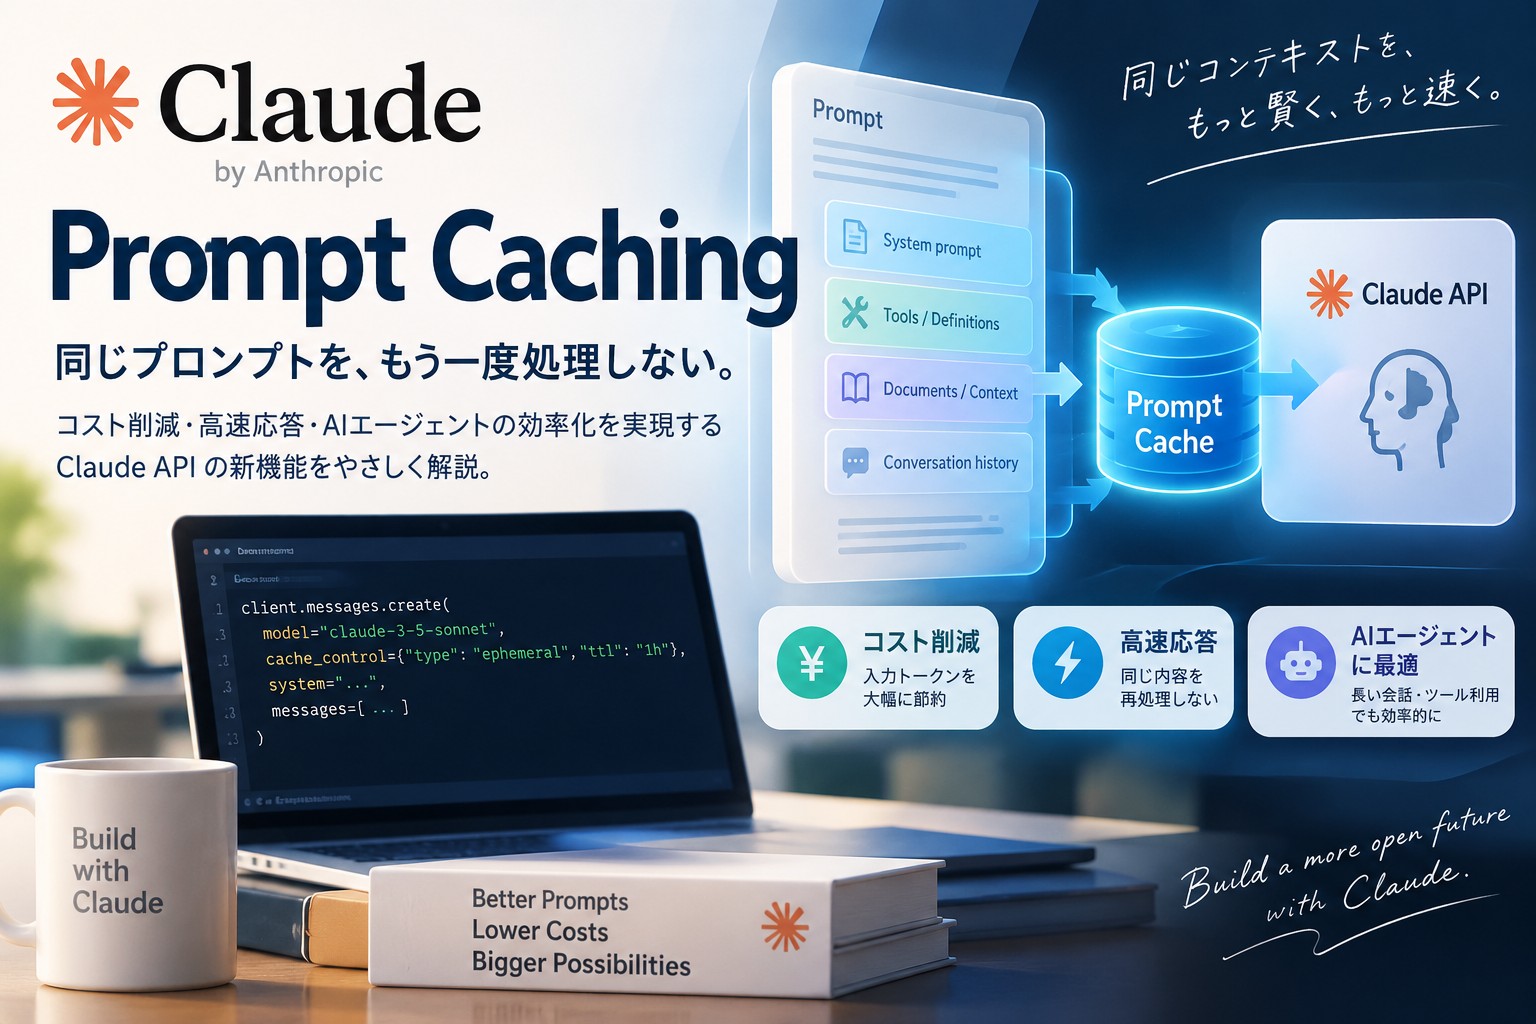
Anthropicが提供するClaude APIには、AIアプリケーションのコストとレスポンス速度を改善する「Prompt Caching(プロンプトキャッシング)」機能が用意されている。
Prompt Cachingは、毎回同じ内容をClaudeへ送り直して処理させるのではなく、プロンプトの共通部分を一時的にキャッシュし、次回以降のAPIリクエストで再利用する仕組みだ。特にClaude CodeのようなAIエージェント、長時間のチャット、巨大なドキュメントを参照するシステムなどでは大きな効果が期待できる。
Anthropic「Prompt caching」公式ドキュメント
Prompt Cachingとは何か
通常、LLMのAPIではリクエストするたびに「system prompt」「過去の会話」「参照資料」「ツール定義」などを入力トークンとして処理する。
例えば、5万トークンの仕様書をClaudeに渡し、
「この仕様について説明して」
続いて、
「では認証部分について詳しく説明して」
と質問した場合、従来は2回目のリクエストでも巨大な仕様書を入力として処理する必要がある。
Prompt Cachingでは、この共通部分をキャッシュして再利用できる。Anthropicによると、tools、system、messagesという順序で構成されるプロンプトの「prefix(先頭から続く共通部分)」がキャッシュ対象になる。(Claude Platform)
つまり単純な「回答結果のキャッシュ」ではない。
Claudeが生成した回答を保存して返すのではなく、Claudeがプロンプトを処理するときの中間表現を再利用する仕組みと考えると分かりやすい。
「Automatic Caching」で導入が簡単に
現在のClaude APIでは、大きく2種類のキャッシュ方法が用意されている。
1つは「Automatic Caching」。APIリクエストのトップレベルにcache_controlを追加すると、最後のキャッシュ可能なブロックまでを自動的にキャッシュする。
もう1つが「Explicit cache breakpoints」で、特定のcontent blockにcache_controlを設定し、どこまでキャッシュするかを開発者が細かく指定する方式だ。(Claude Platform)
特にAutomatic Cachingは、会話履歴が伸びていくチャットやAIエージェントとの相性がいい。会話が続くにつれてキャッシュポイントも前進するため、開発者側で複雑なキャッシュ管理を行う必要が少なくなる。
基本的な指定は次のようなイメージになる。
response = client.messages.create(
    model="...",
    max_tokens=1024,
    cache_control={"type": "ephemeral"},
    system="長いシステムプロンプト...",
    messages=[...],
)
標準TTLは5分、1時間キャッシュにも対応
標準のPrompt Cacheは5分間保持される。ただし、そのキャッシュが利用されるたびにTTLが更新されるため、ユーザーが継続的に会話しているケースではキャッシュを長時間利用できる。(Claude Platform)
さらに、
"cache_control": {
  "type": "ephemeral",
  "ttl": "1h"
}
と指定することで、1時間キャッシュも利用できる。
1時間キャッシュは、ユーザーが数十分おきに操作するサービスや、処理に時間がかかるAIエージェントなどに向いている。一方、頻繁にアクセスされるシステムでは、利用のたびにTTLが更新される標準5分キャッシュの方がコスト面で有利になる場合がある。(Claude Platform)
最大のメリットはAPIコスト削減
Prompt Cachingが重要な理由の一つが料金だ。
キャッシュを最初に作成するときには通常入力より追加コストが発生するが、その後の「cache hit」では通常の入力トークンより大幅に安くなる。公式ドキュメントでは、5分キャッシュの書き込みは通常入力の1.25倍、1時間キャッシュの書き込みは2倍。一方、キャッシュ読み出しは通常入力よりかなり低価格になる料金体系が説明されている。(Claude Platform)
したがって、
巨大なプロンプト × 何度もAPIを呼び出す
というシステムほどPrompt Cachingの効果が大きくなる。
例えば、社内規定、製品マニュアル、ソースコード、API仕様書など数万〜数十万トークンの情報を毎回Claudeへ渡しているサービスでは、キャッシュヒット率を高めることがそのままAPIコスト最適化につながる。
AIエージェントとの相性が非常に良い
特に注目したいのがAIエージェント用途だ。
AIエージェントでは毎回、ツール定義やシステムプロンプト、これまでの会話、ツール実行結果など大量のコンテキストをClaudeへ渡す。
Claude APIではツール定義だけでなく、system message、テキスト、画像・ドキュメント、tool useやtool resultなどもキャッシュ対象にできる。(Claude Platform)
例えば開発エージェントなら、
ツール定義
↓
開発ルール
↓
プロジェクト情報
↓
ソースコード
↓
過去の作業履歴
↓
今回の指示
という巨大な入力になりやすい。
このうち毎回変化しない前半部分をキャッシュできれば、エージェントが何十回もAPIを呼び出して作業する場合の入力コストを大きく抑えられる。
Claude Codeのような「長時間動き続けるAI」の裏側を考えるうえでも重要な技術だ。
キャッシュを事前に温める「Pre-warming」も
さらにAnthropicは「Pre-warming」という仕組みも提供している。
max_tokens: 0を指定して事前にAPIを呼び出すことで、回答を生成せず、system promptやtool definitionsなどをキャッシュへ読み込ませることができる。
ユーザーから最初の問い合わせが来る前にキャッシュを作っておけば、初回アクセス時のキャッシュミスによる遅延を避けられる。リアルタイム性が重要なチャットサービスなどでは興味深い仕組みだ。(Claude Platform)
キャッシュが効かなくなるケースには注意
一方、Prompt Cachingは「同じprefix」を再利用する技術なので、前半部分を変更するとキャッシュが無効になる可能性がある。
例えばtool definitionsを変更すると、その後に続くsystemやmessagesのキャッシュにも影響する。またClaudeのthinking設定やeffortをリクエストごとに変更することでもキャッシュが無効になる場合がある。Anthropicは、同じ会話ではthinking設定やeffortを維持することを推奨している。(Claude Platform)
そのため、
変化しない情報を前、頻繁に変化する情報を後ろ
というプロンプト設計が重要になってくる。
キャッシュが実際に使われたかどうかはAPIレスポンスのcache_creation_input_tokensとcache_read_input_tokensで確認できる。モデルごとに最低キャッシュ可能トークン数も設定されており、それを下回る短いプロンプトではcache_controlを指定してもキャッシュされない。(Claude Platform)
LLM開発では「キャッシュ設計」が重要になる
Prompt Cachingは単なる料金節約機能ではない。
Claude APIでは長いコンテキストや大量のツールを利用するAIエージェントが増えており、「どの情報を毎回処理し、どの情報をキャッシュするか」がアプリケーション設計の一部になりつつある。
AnthropicはPrompt Cachingに加え、長い会話を要約するCompactionやContext Editingなど、コンテキスト管理関連の機能を拡充している。(Claude Platform)
これまでLLM開発では「良いプロンプトを書くこと」が注目されてきた。しかしAIエージェント時代には、
プロンプトをどう配置するか、どこをキャッシュするか、どこまでコンテキストとして維持するか
という「コンテキスト設計」が、コストと速度を左右する重要な技術になりそうだ。
特に大量のコードやドキュメントを扱う開発支援AI、社内RAG、カスタマーサポート、長時間稼働するマルチエージェントなどをClaude APIで構築している開発者にとって、Prompt Cachingは最初に検討しておきたい最適化機能の一つと言える。
関連URL:
Claude Platform — Prompt caching
Claude Platform — Features overview