
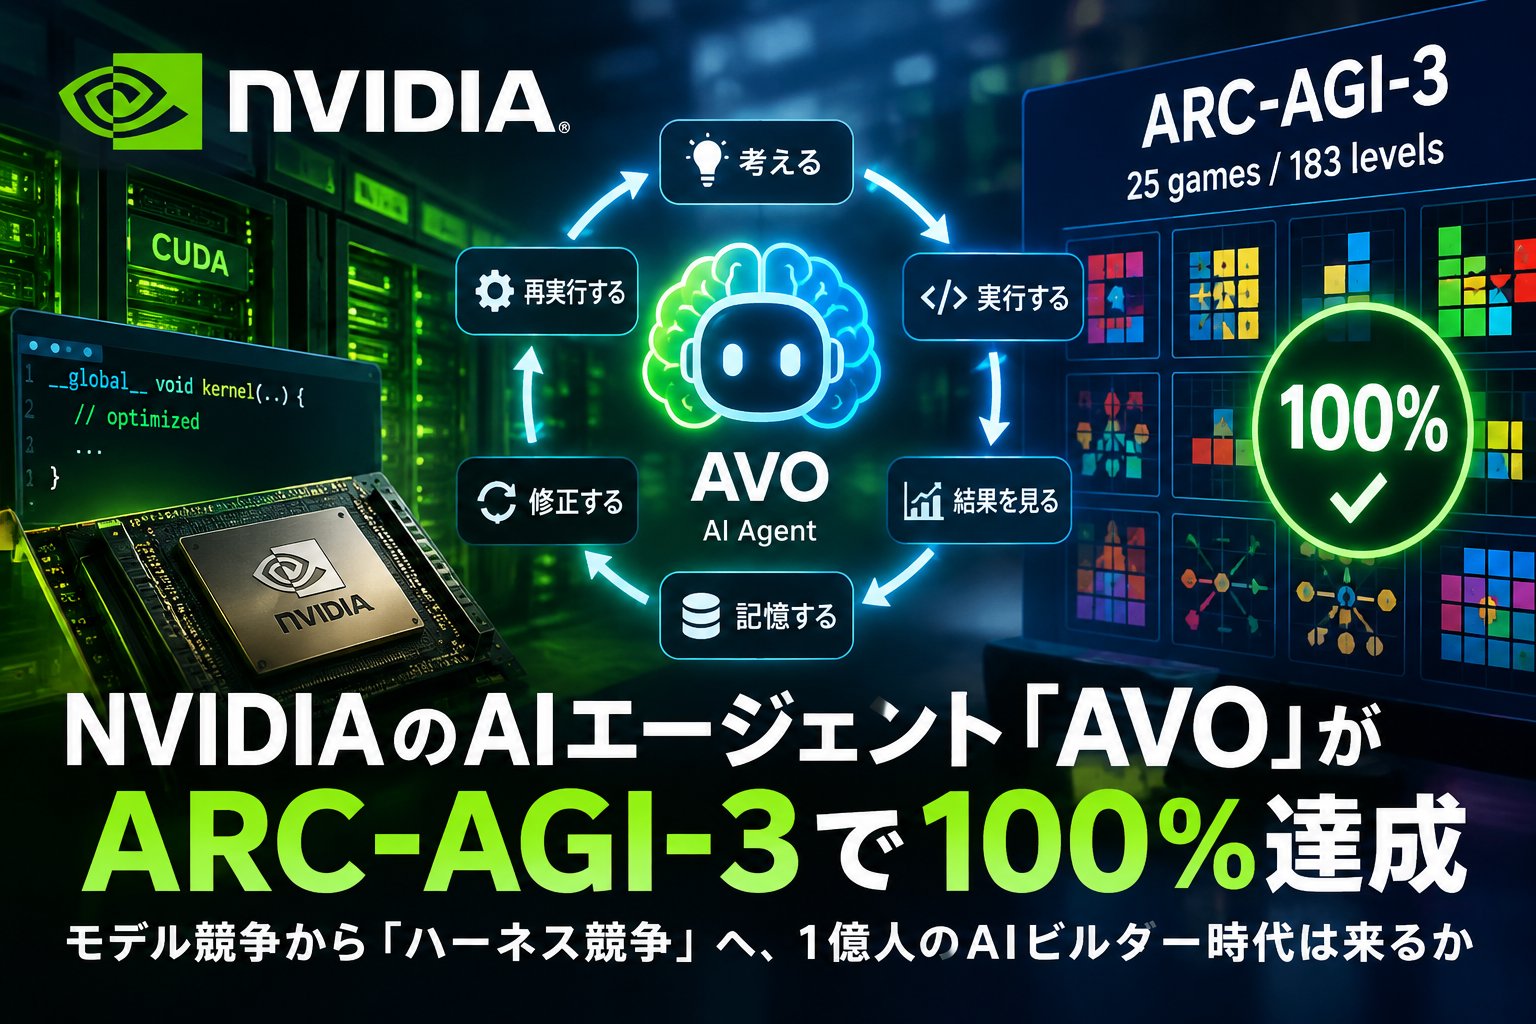
NVIDIAが開発したAIエージェントシステム「AVO(Agentic Variation Operators)」が、AIの適応能力を測るベンチマーク「ARC-AGI-3」の公開セットで100%のスコアを達成した。25の公開ゲーム環境に含まれる全183レベルをクリアしたという。
注目すべきなのは、単純に「強力な新AIモデルが登場した」という話ではない点だ。AVOはもともと、CUDA GPUカーネルなどの高度なコードを自律的に最適化するために開発されたエージェントアーキテクチャであり、既存の大規模言語モデルを「どのように働かせるか」を工夫することで能力を大きく引き出している。
AI開発競争は、モデルそのものの性能だけを競う段階から、「モデル+エージェント+ツール+記憶+実行環境」を含めたシステム全体の競争へ移り始めている。
CUDAカーネル最適化から生まれた「AVO」
NVIDIAによると、AVOは長時間にわたって自律的に作業を続けることを重視した汎用コーディングエージェントだ。
通常の生成AIに「高速なCUDAコードを書いて」と依頼するだけでは、高性能なGPUカーネルを作るのは難しい。実際の最適化では、既存コードの解析、仮説の作成、コード変更、コンパイル、テスト、GPU上でのベンチマーク、結果の分析、再修正というサイクルを何度も回す必要がある。
AVOは、この工程そのものをAIエージェントに任せる。
NVIDIAの実験では、AVOが7日間継続して動作し、500以上の最適化方針を探索。40バージョンのカーネルを生成・コミットした。DGX B200上で評価したマルチヘッドアテンションのカーネルは、cuDNNを最大3.5%、FlashAttention-4を最大10.5%上回ったという。さらに、その成果をGrouped-Query Attention向けに適応する作業も約30分で自律的に行った。 (NVIDIA Developer)
これまでGPUカーネルの最適化は、CUDAやGPUアーキテクチャに精通した一部のエンジニアが行う高度な専門作業だった。その試行錯誤の大部分をAIエージェントが担えるようになる可能性を示したことは大きい。
ARC-AGI-3の25環境・183レベルを完全攻略
そしてAVOの能力を別分野で検証するために利用されたのが「ARC-AGI-3」だ。
ARC-AGI-3は従来の質問回答型ベンチマークとは大きく異なる。AIは未知のゲーム環境に放り込まれ、ルールも目的も説明されない。実際に操作し、「この行動をすると何が起きるのか」を観察しながらルールと勝利条件を推測する必要がある。ARC Prizeによれば、人間は100%に到達できる一方、公開時点のフロンティアAIは極めて低い成績だった。 (ARC Prize)
AVOは今回、公開セットの25環境にある全183レベルをクリアし、100.00 RHAEを達成した。
使用された基盤モデルはAnthropicの「Claude Opus 5」。AVOでは画像そのものをモデルに入力するのではなく、ゲーム状態を64×64のテキストグリッドとして与え、ルールや目的を明示しない状態から試行錯誤させたという。
全183レベルを攻略するまでに使用した環境アクション数は6,624回。同じ公開セットをClaude Opus 5でクリアしたVISTAの7,542回と比較すると、約12%少ない。ただしNVIDIA自身も、両システムでは観測表現やメモリ、コンテキスト管理などが異なるため、厳密な条件を揃えた比較ではないと注意している。 (NVIDIA Developer)
本当に重要なのは「モデル」ではなく「ハーネス」か
今回の結果で特に興味深いのが、「AIモデル単体の性能」と「AIエージェントシステムとしての性能」が別物になりつつあることだ。
AVOでは、モデルの周囲に「ハーネス」と呼ばれる仕組みを構築する。
ハーネスは、モデルにツールを使わせ、実行結果を確認させ、失敗したら修正させる。また、長時間の作業で重要な情報を失わないよう状態や記憶を管理する。AVOの場合は、メインエージェントだけでなく、探索全体を監視し、行き詰まった際に介入するSupervisorなども組み込まれている。
つまり、
モデル → コードを書く
という単純な構造から、
考える → 実行する → 結果を見る → 記憶する → 仮説を修正する → 再実行する
という継続的なループへ変わっている。
NVIDIAがARC-AGI-3で示したのは、GPUカーネル最適化用に構築したエージェントの基本構造が、未知のゲーム攻略というまったく異なる問題にも転用できたという点だ。 (NVIDIA Developer)
「1億人のAIビルダー」はいつ実現するのか
Hugging Face共同創業者兼CEOのClément Delangue氏は、この動きを受けて「1億人のAIビルダーはいつ実現するのか?」と問いかけている。
この問いは、今回のニュースの本質をよく表している。
これまで独自AIモデルの開発やポストトレーニング、GPUカーネルの高速化には、機械学習、CUDA、分散処理などに関する高度な専門知識が必要だった。
しかしエージェントが「実装→実行→評価→改善」のループを自律的に回せるようになれば、人間側に求められる能力は変化する。
人間が細かなCUDAコードを書くのではなく、
「このモデルをこのGPUで高速化したい」
「推論コストを半分にしたい」
「このデータを使って用途特化モデルを作りたい」
といった目標を設定し、AIエージェントが実装や検証を担当する世界だ。
そうなれば「AIを使う人」だけでなく、「AIを使ってAIを作る人」が急増する可能性がある。
AI開発は「モデル競争」から「エージェントシステム競争」へ
2020年代前半の生成AI競争では、パラメータ数、学習データ、推論能力、ベンチマークスコアなど、モデルそのものに注目が集まっていた。
しかし2026年になり、その構図は変わりつつある。
同じモデルでも、どのようなツールを与えるのか。どのように記憶させるのか。失敗からどう復帰させるのか。長時間のタスクをどう管理するのか。そして、実世界から得られるフィードバックをどう次の行動へ反映させるのか。
こうした「モデルの外側」の設計が、AIの実用能力を大きく左右する。
NVIDIAがAVOについて強調している「The model matters, but the model is not the entire agent(モデルは重要だが、モデルがエージェントのすべてではない)」という考え方は、今後のAI開発を象徴する言葉になりそうだ。 (NVIDIA Developer)
1億人のAIビルダーが誕生する時代は、単に「もっと賢いモデル」が登場したときではないのかもしれない。
高度なAI開発をエージェント自身が代行できるようになったとき、AI開発そのものが大衆化する。
AVOのARC-AGI-3完全攻略は、その未来が少しずつ現実になっていることを示す事例と言えるだろう。
関連URL
- NVIDIA Technical Blog:AVO Reaches 100% on ARC-AGI-3
- NVIDIA:Six Agent Harness Capabilities for Higher Model Performance
- ARC Prize:Announcing ARC-AGI-3
- ARC-AGI-3 Benchmarking GitHub
- Clément Delangue氏の投稿(X)
なお、元の情報にある「CUDA GPUカーネルを最適化するための独自ハーネスを構築し、そのハーネスがARC-AGI-3で100%」という表現は大筋で合っていますが、より正確には、CUDA最適化で実証した汎用エージェントアーキテクチャ「AVO」をARC-AGI-3向けのインターフェースに接続したという説明になります。NVIDIA自身も、GPU最適化とARC-AGI-3で基礎となるエージェントは同じだと説明しています。 (NVIDIA Developer)